Gemma 3n を Android で動かす実装手順|スマホにダウンロードした LLM でオフライン翻訳するまで
スマホにダウンロードした LLM でオフライン翻訳できることを確かめる、という試作の目的は達成した。本稿は、この試作(Gemma 3n を使う Android アプリ)で推論するまでの 6 つの手順を実物のコードで示す。モデルが無い、初期化や推論に失敗した、といった場合は ML Kit の翻訳で下支えした。試作の翻訳画面は次のとおり。
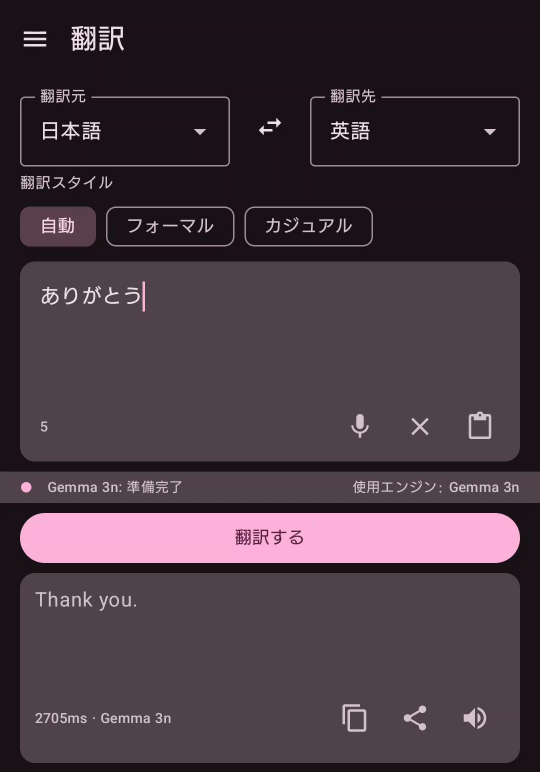
結果欄の 2705ms は、筆者の端末(Xperia 1 VII、Snapdragon 8 Elite、RAM 12GB)で 5 文字を訳したときにアプリが表示した翻訳処理の時間で、モデルの読み込みと画面の描画を含まない。1 回の観測で、速さの目安ではない。
なお、公式の「LLM Inference guide for Android」は、2026 年 10 月時点で MediaPipe LLM Inference API をメンテナンスのみの扱いとし、LiteRT-LM の Android(Kotlin)API への移行を勧めている。依存関係の例も tasks-genai 0.10.27 に進んでいる。本稿は 2026 年 3 月時点に MediaPipe で組んだ試作の手順の記録であり、LiteRT-LM の使い方は扱わない。
アプリは Kotlin・Jetpack Compose・Hilt・Room 製で、メインの推論は MediaPipe LLM Inference、構成は tasks-genai 0.10.24、ML Kit translate 17.0.3、Gemma 3n E2B の INT4 量子化版(.task)、compileSdk 35・targetSdk 34・minSdk 26 である。
1. モデルを入手する
README の手順では、Kaggle か Hugging Face でライセンスに同意して gemma-3n-E2B-it-int4.task をダウンロードする。ただし README が示す Hugging Face のページは safetensors 版で、.task は別の配布ページ(参照欄。同じくライセンスへの同意が必要)にあった(2026 年 10 月に確認)。モデルは著作権の都合と大きさから git に入れない(.gitignore に *.task・*.litertlm)。
// app/src/main/java/com/example/offlinetranslator/engine/ModelConfig.kt から抜粋
    const val MODEL_FILENAME = "gemma3n-e2b.task"

    /**
     * モデルのダウンロードURL。
     * HuggingFace は認証が必要なため自動ダウンロード非対応。
     * 開発時は adb push で手動配置し、本番用URLが確定したらここを更新する。
     // …
     */
const val MODEL_DOWNLOAD_URL = "" // TODO: 認証付きダウンロード実装時に設定ダウンロードの処理(ModelDownloadManager)は残してあり、URL が空なら手動配置を促して止まる。配布の経路は決めないまま試作を終えた。
2. 依存関係とビルド設定
version catalog に MediaPipe の tasks-genai と ML Kit の translate を加える。
# gradle/libs.versions.toml から抜粋
mlkitTranslate = "17.0.3"
mediapipe = "0.10.24"
# …
mlkit-translate = { group = "com.google.mlkit", name = "translate", version.ref = "mlkitTranslate" }
mediapipe-tasks-genai = { group = "com.google.mediapipe", name = "tasks-genai", version.ref = "mediapipe" }
アプリのモジュールでは dependencies に取り込み、MediaPipe と他のライブラリの間で衝突する libc++_shared.so は pickFirsts で 1 つに絞った。
// app/build.gradle.kts から抜粋
    packaging {
        jniLibs {
            // MediaPipe と他ライブラリ間の libc++_shared.so 衝突を回避
            pickFirsts += setOf("**/libc++_shared.so")
        }
    }
    // …
    implementation(libs.mlkit.translate)
    implementation(libs.mediapipe.tasks.genai)
リリースビルドで R8 の minify と shrinkResources を有効にしたので、消されないよう app/proguard-rules.pro で MediaPipe と ML Kit のクラスを keep した。
3. 端末にモデルを置く
README の手順では、adb push でいったん /data/local/tmp に送り、run-as でアプリの files/models/ へコピーする。
# README.md から抜粋
# …
adb push gemma-3n-E2B-it-int4.task /data/local/tmp/gemma3n-e2b.task
adb shell run-as com.example.offlinetranslator \
    cp /data/local/tmp/gemma3n-e2b.task files/models/gemma3n-e2b.task
アプリは URL が空のとき files/models/ を作らないので、README のエミュレータの手順と同じく先に adb shell run-as com.example.offlinetranslator mkdir -p files/models でフォルダを作っておく。アプリは context.filesDir 配下の models/gemma3n-e2b.task を読み、ファイルが無ければ ML Kit だけで動く。
公式のクイックスタートは /data/local/tmp/llm/ に置いたまま、そのパスを setModelPath に渡すので、アプリの領域へコピーする点が違う。公式は本番では、モデルが APK には大きすぎるのでサーバーに置き、実行時にダウンロードするよう勧めている。1 章の MODEL_DOWNLOAD_URL が空のまま待っているのは、この形の配布である。
4. LlmInference を初期化する
端末の総 RAM(totalMem)が 2GB 未満か、モデルが無ければ Gemma の初期化を飛ばす。RAM の条件は CLAUDE.md の制約で、README は Gemma 使用時に RAM 4GB 以上を推奨している。
// app/src/main/java/com/example/offlinetranslator/engine/GemmaTranslationEngine.kt から抜粋
    override suspend fun initialize() {
        if (!isRamSufficient()) {
            // …
            return
        }
        // …
        try {
            withContext(Dispatchers.IO) {
                val options = LlmInference.LlmInferenceOptions.builder()
                    .setModelPath(modelPath)
                    .setMaxTokens(256)
                    .build()
                llmInference = LlmInference.createFromOptions(context, options)
            }
            _isReady.value = true
// …成功したら準備完了のフラグ(isReady)を立て、失敗しても翻訳は ML Kit で続く。ただし ML Kit も、初期化のときに日→英・英→日の翻訳モデルを downloadModelIfNeeded で端末に取り込むので、初回だけはネットワークが要る。
初期化は起動時に WorkManager の enqueueUniqueWork(ExistingWorkPolicy.KEEP)で登録し、実行中なら重ねて走らせない。ワーカーは Gemma と ML Kit の初期化を同時に起動し、失敗しても再試行させないよう成功を返す。
5. 推論して翻訳を取り出す
プロンプトは PromptTemplates.kt に、応答の整形は ResponseParser.kt に集めた。これも CLAUDE.md に書いた制約である(CLAUDE.md を短く保つ考え方)。Gemma のチャットテンプレートで組み、「Output ONLY the translation」で余計な出力を抑え、言語の方向ごとに 1 件の few-shot で形を安定させる。言語とスタイルは画面で選ぶ。
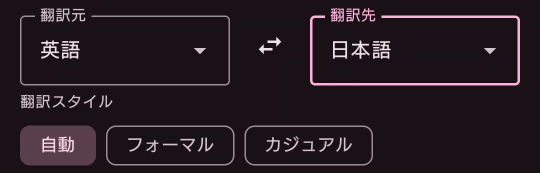
次は 3 つの翻訳スタイル(AUTO・FORMAL・CASUAL)のうち AUTO である。
// app/src/main/java/com/example/offlinetranslator/engine/PromptTemplates.kt から抜粋
    private fun buildAutoPrompt(text: String, src: Language, tgt: Language): String {
        val example = formatExample(autoExample(src, tgt))
        return """<start_of_turn>user
Translate the following ${src.displayName} text into ${tgt.displayName}.
Output ONLY the translation. Do not add explanations, notes, or any other text.

$example

Input: $text<end_of_turn>
<start_of_turn>model
Output:"""
    }
コードのコメントにあるとおり LlmInference はスレッドセーフでないとして、推論は Mutex で 1 本ずつにし、120 秒のタイムアウトの中で generateResponse を呼ぶ。
// app/src/main/java/com/example/offlinetranslator/engine/GemmaTranslationEngine.kt から抜粋
    /** 同時推論を防ぐ Mutex(LlmInference はスレッドセーフでない) */
    private val mutex = Mutex()
    // …
    ): String = mutex.withLock {
        // …
        try {
            withTimeout(INFERENCE_TIMEOUT_MS) {
                withContext(Dispatchers.IO) {
                    val raw = inference.generateResponse(prompt)
                    ResponseParser.parseTranslationResponse(raw, targetLang)
                }
            }
        } catch (e: TimeoutCancellationException) {
            throw TranslationException.InferenceTimeout("Gemma", INFERENCE_TIMEOUT_MS)
        // …
翻訳の処理中は翻訳ボタンを押せず、結果欄に読み込みの表示が出る。
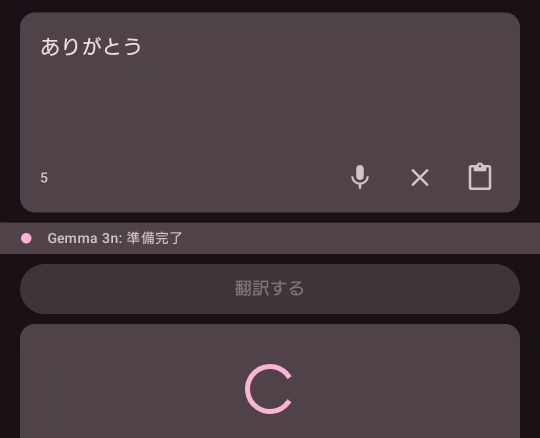
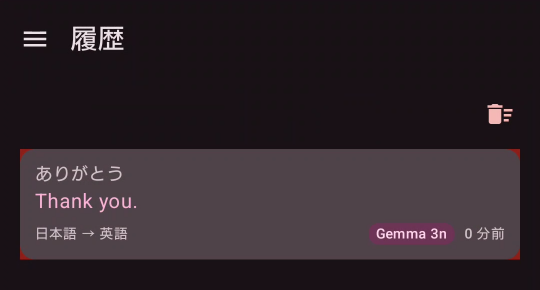
ResponseParser は、ターンマーカー、Output: などの接頭辞、前後の空行、囲みの引用符を取り除き、説明文が付いていれば最初の段落だけを残す。Gemma がタイムアウトを含む例外で失敗したら、Repository が ML Kit で訳し直し、使ったエンジンとフォールバックの有無(usedFallback)を結果に持たせる。履歴の画面にも、訳したエンジンのラベルが付く。
6. メモリを返す
UI が見えなくなったときとメモリが逼迫したときに、close() でモデルを解放する。
// app/src/main/java/com/example/offlinetranslator/OfflineTranslatorApp.kt から抜粋
    override fun onTrimMemory(level: Int) {
        // …
        when {
            level >= ComponentCallbacks2.TRIM_MEMORY_UI_HIDDEN -> {
                // …
                gemmaEngine.close()
            }
            level >= ComponentCallbacks2.TRIM_MEMORY_RUNNING_CRITICAL -> {
                // …
                gemmaEngine.close()
            }
        // …
フォアグラウンドに戻って未ロードなら、4 章と同じ作業で初期化を予約し直す。RAM を見るのは初期化時だけで、ロード済みなら翻訳時に空き RAM は見ない。
まとめ
6 つの手順に ML Kit の下支えを組み合わせた試作で、オフラインで翻訳できることを確かめるという目的は達成した。
筆者は振り返りで、指示ごとにコミットすべきだった(開発中のコミットは 0 件で、後から当時の状態を固定する初回コミットを作った)、モデルの入手と配置の経路をアプリの骨格より先に確かめるべきだった、と考えている。新しく作るなら、LiteRT-LM の案内を先に確かめてほしい。
--- 参照: オフライン翻訳アプリのリポジトリ(README・CLAUDE.md・.gitignore・ビルド設定・Kotlin ソース・コミット本文。2026-10-27 確認)。LLM Inference guide for Android: https://developers.google.com/edge/mediapipe/solutions/genai/llm_inference/android (ページの最終更新 2026-06-12)/ ML Kit 翻訳(Android): https://developers.google.com/ml-kit/language/translation/android / Gemma 3n: https://www.kaggle.com/models/google/gemma-3n ・ https://huggingface.co/google/gemma-3n-E2B-it (README の案内先。safetensors 版)・ https://huggingface.co/google/gemma-3n-E2B-it-litert-preview (.task の配布ページ)(いずれも 2026-10-27 確認)。